第 1 节
2022 年底,ChatGPT 横空出世,让全世界看到了大语言模型(LLM)的能力。但很快开发者们发现一个尴尬的现实:单纯调用模型 API 远远不够。
你让它"总结这份 PDF",它看不到文件;你让它"根据公司知识库回答客户问题",它没有你的数据;你让它"帮我订一张去北京的机票",它没有操作任何系统的权限。
也就是说,LLM 本身只是一个"聪明但失忆、且没有手脚的大脑"。要把它变成真正可用的产品——客服机器人、文档问答、自动化助手——你需要围绕它搭建大量的"脚手架":
- 把文档切块、向量化、存进数据库(RAG)
- 管理多轮对话的历史记忆
- 让模型能调用外部工具
- 把多个处理步骤串成流水线
- 随时切换不同的模型供应商
每一次都从零手写这些逻辑,既痛苦又重复。于是,LangChain 应运而生。
什么是 LangChain?
LangChain 是一个开源的、用于构建大语言模型应用(LLM Application)的开发框架,由 Harrison Chase 于 2022 年 10 月创建,如今已经成为 AI 应用开发领域事实上的标准之一(GitHub Star 数超过 12 万)。
它的核心设计理念可以概括为三句话:
- 标准化:把 LLM 应用开发中的高频需求抽象成统一接口;
- 模块化:每个能力都是独立积木,按需取用、自由组合;
- 可组合:用声明式的方式把积木拼装成完整的应用流程。
它提供 Python 和 JavaScript/TypeScript 两个版本,无论你熟悉哪个语言生态都能上手。
核心组件:八块积木
LangChain 官方文档中,生态被划分为多个子项目(LangChain Core、LangChain Community、LangGraph、LangSmith 等),其中日常开发最常打交道的核心组件有这些:
1. Models(模型)
统一封装了各种模型的调用接口,主要分三类:
- LLM:传统的纯文本补全模型(text-in → text-out);
- Chat Models:对话式模型,输入消息列表,输出消息对象(主流,如 GPT-4o、Claude、DeepSeek);
- Embedding Models:把文本转为向量,用于检索和语义相似度计算。
得益于统一抽象,切换模型供应商时只需改一行配置:
# 从 OpenAI 切换到任意兼容模型,只需换这里的实例from langchain_openai import ChatOpenAIllm = ChatOpenAI(model="gpt-4o")2. Prompts(提示词)
提示词工程的工程化封装:支持模板变量、少样本示例(Few-shot)、消息角色(System / User / Assistant)等。
from langchain_core.prompts import ChatPromptTemplate
prompt = ChatPromptTemplate.from_messages([ ("system", "你是一位专业的{field}顾问,回答要简洁专业。"), ("user", "请帮我分析:{question}"),])
# 渲染后的消息可以直接传给模型3. Chains 与 LCEL(链)
LCEL(LangChain Expression Language)是 LangChain 的声明式组合语法,用管道符 | 把多个组件串成流水线——这是 LangChain 最优雅的设计之一:
chain = prompt | llm | output_parserresult = chain.invoke({"field": "投资", "question": "如何看待当前市场?"})数据从左到右流过每个环节,清晰、可调试、可并行、可流式输出。
4. Retrievers 与 Vector Stores(检索与向量库)
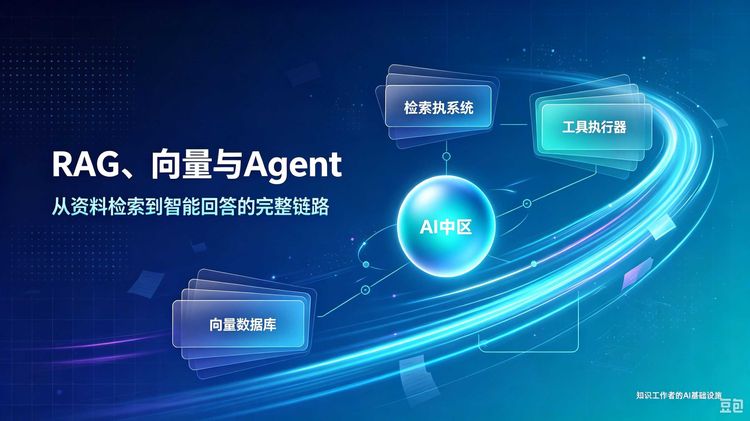
这是 RAG(检索增强生成) 的基石。流程是:
- 文档切块(Splitter);
- 用 Embedding 模型向量化;
- 存入向量数据库(如 Chroma、Pinecone、FAISS、Milvus);
- 用户提问时,检索最相关的片段;
- 把片段拼进提示词,让模型"基于资料"回答。
from langchain_community.vectorstores import FAISS
# 假设 docs 已经切块并向量化vectorstore = FAISS.from_documents(docs, embeddings)retriever = vectorstore.as_retriever(search_kwargs={"k": 4})5. Agents(智能体)
让 LLM 从"被动回答"进化为"主动行动":模型根据任务自主决定调用哪个工具、按什么顺序、何时结束。
from langchain.agents import create_tool_calling_agent, AgentExecutor
# 给模型配备工具:搜索、计算器、查天气……tools = [search_tool, calculator_tool, weather_tool]agent = create_tool_calling_agent(llm, tools, prompt)executor = AgentExecutor(agent=agent, tools=tools)6. Memory(记忆)
对话式应用必备:保存历史消息、摘要对话、按需注入上下文。支持简单缓冲、滑动窗口、摘要记忆等多种策略。
7. Tools(工具)
任何外部能力都可以包装成 Tool:调用 REST API、执行 SQL、读写文件、调用搜索引擎……把"模型的手脚"接上。
8. Callbacks 与 Tracing(回调与追踪)
监控每一轮调用的输入输出、耗时、Token 消耗,方便调试与线上观测。
一个完整的入门示例
下面是一个"文档问答机器人"的最小实现,串起了上面大部分组件:
from langchain_openai import ChatOpenAI, OpenAIEmbeddingsfrom langchain_community.document_loaders import PyPDFLoaderfrom langchain.text_splitter import RecursiveCharacterTextSplitterfrom langchain_community.vectorstores import FAISSfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_core.output_parsers import StrOutputParser
# 1. 加载并切分文档loader = PyPDFLoader("company_manual.pdf")docs = loader.load()splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)chunks = splitter.split_documents(docs)
# 2. 向量化并存入向量库embeddings = OpenAIEmbeddings()vectorstore = FAISS.from_documents(chunks, embeddings)retriever = vectorstore.as_retriever()
# 3. 组装 RAG 链prompt = ChatPromptTemplate.from_template( "仅根据以下资料回答用户问题,不要编造:\n\n{context}\n\n问题:{question}")llm = ChatOpenAI(model="gpt-4o")
def format_docs(docs): return "\n\n".join(d.text for d in docs)
rag_chain = ( {"context": retriever | format_docs, "question": lambda x: x["question"]} | prompt | llm | StrOutputParser())
# 4. 提问print(rag_chain.invoke({"question": "年假政策是怎样的?"}))LangChain 生态全家桶
现在的 LangChain 早已不止一个库,而是一整套生态:
| 项目 | 定位 |
|---|---|
| LangChain Core | 核心抽象:接口、消息、输出解析等 |
| LangChain | 链、代理、检索等高层组件 |
| LangChain Community | 数百种第三方集成(向量库、工具、模型) |
| LangGraph | 用图(Graph)编排有状态、复杂的 Agent 工作流,官方推荐的 Agent 生产级方案 |
| LangSmith | 商业化的调试、监控、评测平台 |
常见疑问与避坑指南
Q1:LangChain 和 LangGraph 是什么关系? LangGraph 是 LangChain 官方推出的新一代编排引擎,面向复杂 Agent 和有状态流程。简单线性任务用 Chain 就够了,复杂分支、循环、人机协作建议直接用 LangGraph。
Q2:学 LangChain 还是直接用原生 SDK? 如果只是单次调用,原生 SDK 更轻;一旦涉及 RAG、Agent、多工具、多模型切换,LangChain 的抽象能显著减少重复代码。生产环境也可考虑 langchain + langgraph 组合。
Q3:为什么网上教程经常报错? LangChain 迭代极快,API 变动频繁(尤其 0.1 → 0.2 → 0.3 → 1.x)。建议以官方文档为准,注意教程对应的版本,优先使用较新版本。
Q4:有没有替代品? 有,比如 LlamaIndex(专注 RAG 与数据)、Haystack、以及各大厂商自己的 SDK。选型取决于场景:数据密集型选 LlamaIndex,通用编排与 Agent 选 LangChain。
LangChain 真正带来的价值,不是某个炫酷的 API,而是一套思考 LLM 应用的框架:把"模型、提示词、数据、工具、记忆、流程"当作可以自由组合的积木。
理解了这八个核心组件,你就掌握了绝大多数 LLM 应用的骨架。剩下的,就是挑选合适的积木,搭出属于你的应用。
说两句
有想补充或想问的,就写在这里。